

IA locale su Linux: perché Ollama ha cambiato il modo in cui lavoro

Uso l’IA ogni giorno. Non è più una cosa che faccio ogni tanto per curiosità: è diventata parte del flusso di lavoro, come il terminale o il browser. La uso per scrivere testi e creare contenuti, per generare immagini, per il codice; ho anche realizzato un paio di programmi partendo da zero senza essere uno sviluppatore. È diventata una protesi del lavoro creativo e tecnico, nel bene e nel male.L’IA mi fa fare più cose nello stesso tempo, e questo mi lascia scegliere se usare il tempo guadagnato per fare ancora di più, o semplicemente smettere prima.

Il problema con i servizi cloud come ChatGPT, Gemini o Claude è che quello che scrivi esce dalla tua macchina. Ogni prompt, ogni documento che incolli, ogni frammento di codice va su un server di qualcun altro. Per uso personale ci si può stare, ma se lavori su codice proprietario, dati aziendali, o semplicemente preferisci che la tua roba resti tua, il cloud smette di essere la risposta giusta.
Qui entra in gioco l’IA locale. E su Linux è diventata un’opzione concreta anche senza hardware da server.
Perché locale e non cloud
I motivi per cui vale la pena considerare l’IA locale invece di un abbonamento cloud sono quattro, e sono tutti pratici:
Privacy totale. I tuoi prompt non escono dalla macchina. Puoi incollare codice sorgente, dati personali, contratti, e non stai inviando niente da nessuna parte. Per chi lavora con informazioni sensibili, questa non è una comodità: è un requisito.
Nessun abbonamento. ChatGPT Plus costa 20€ al mese, Claude Pro altrettanto. L’IA locale ha un costo una tantum: l’hardware che probabilmente hai già, e qualche gigabyte di download per il modello.
Funziona offline. In treno, in viaggio, con la connessione che fa i capricci: il modello locale non se ne accorge.
Controllo sul modello. Puoi scegliere quale modello usare, aggiornarlo quando vuoi, tenerlo fermo su una versione specifica se quella funziona bene per il tuo caso d’uso.

Cosa ti serve per farlo girare
Questa è la parte dove la maggior parte degli articoli esagera, in un senso o nell’altro. Non ti serve una GPU da gaming per iniziare. Quello che conta è la RAM, non i core della GPU.
| RAM disponibile | Modelli utilizzabili | Velocità indicativa |
|---|---|---|
| 8 GB | Gemma3 4B, Qwen3 4B, Phi-4 mini | Lenta ma usabile (5-15 tok/s su CPU) |
| 16 GB | Llama3.1 8B, Gemma3 12B, Mistral 7B, Qwen3 8B | Buona su CPU, ottima con iGPU accelerata |
| 32 GB | Gemma3 27B, Qwen3 32B, DeepSeek R1 14B | Ottima per uso quotidiano avanzato |
| 64 GB+ | Modelli da 30-70B con MoE | Qualità vicina ai modelli cloud |
Se hai un mini PC con 16GB di RAM unificata e CPU AMD con iGPU Radeon, che è esattamente il profilo dei mini PC AMD che trovi su questo sito, sei in un punto molto comodo: i modelli da 7-8B girano bene anche solo su CPU, e con l’accelerazione iGPU la velocità migliora sensibilmente.
👉 Leggi qui: CPU AMD o Intel nel Mini PC: quale scegliere su Linux
Ollama: un comando e il modello gira
Ollama è diventato lo standard per eseguire modelli LLM in locale su Linux. Lo installi con una riga:
curl -fsSL https://ollama.com/install.sh | sh
Da quel momento, scaricare e avviare un modello è semplice:
ollama run llama3.1
Ollama scarica il modello, lo carica in memoria e ti apre una sessione di chat direttamente nel terminale. Funziona anche come server locale con API compatibile con OpenAI. Questo significa che qualsiasi tool costruito per ChatGPT può puntare al tuo Ollama locale senza modifiche.
I comandi che usi di più:
ollama list                  # modelli scaricati
ollama ps                    # modelli in esecuzione
ollama pull gemma3:12b       # scarica un modello
ollama rm nome-modello       # rimuove un modello
Quali modelli scegliere nel 2026
Il panorama cambia velocemente. Quello che ti scrivo qui è verificato a luglio 2026, ma tra sei mesi la situazione sarà diversa. Tienilo a mente.
Per uso quotidiano generico (testi, email, riassunti) con 16GB di RAM: gemma3:12b è la scelta più equilibrata. Occupa circa 8GB, risponde bene in italiano, e gira in modo fluido anche solo su CPU. Alternativa solida: qwen3:8b, che ha licenza Apache 2.0 e funziona molto bene in multilingua.
ollama run gemma3:12b
ollama run qwen3:8b
Per coding con 16GB: qwen2.5-coder:7b (4.7GB) è il punto di partenza. Se hai 32GB disponibili, qwen3-coder:30b è attualmente uno dei migliori modelli per codice in assoluto, open o chiuso.
Per ragionamento e problemi complessi: deepseek-r1:8b ti dà chain-of-thought in locale. È lento perché pensa ad alta voce prima di rispondere, ma per domande che richiedono passaggi logici espliciti è sorprendente.
Per chi ha solo 8GB: gemma3:4b (3.3GB) o phi4-mini sono le opzioni. Le risposte sono più brevi e meno articolate, ma per compiti semplici funzionano.
Open WebUI: dimentica il terminale
Usare Ollama da terminale va bene per i primi test, ma per usarla tutti i giorni vuoi qualcosa che somigli a ChatGPT. La soluzione più semplice su Linux è Msty: la scarichi, la apri, e funziona.
Vai sul sito, scarica il file AppImage, poi apri il terminale nella cartella dove l’hai scaricato e scrivi:
bash
chmod +x Msty-*.AppImage
./Msty-*.AppImage
Al primo avvio ti chiede per cosa la vuoi usare. Clicca “Skip to app” in basso a destra e sei dentro. Se Ollama è già in esecuzione, Msty lo trova da solo e i modelli che hai scaricato appaiono direttamente in basso. Scrivi il tuo messaggio e l’IA risponde, esattamente come faresti su ChatGPT, ma tutto gira sul tuo computer.

L’altra opzione molto diffusa è Open WebUI, che si apre nel browser invece che come app desktop. Su Ubuntu e Debian funziona bene, ma su CachyOS e Arch Linux al momento ha un problema di compatibilità con Python 3.13 e l’installazione non va a buon fine. Se sei su queste distribuzioni, usa Msty senza pensarci.
AMD Radeon 780M su Linux: come attivare l’accelerazione GPU
Questa sezione è specifica per chi ha un mini PC con Ryzen 7xxx/8xxx e iGPU Radeon 780M (gfx1103), che include praticamente tutti i mini PC AMD di fascia media attuali.
L’accelerazione GPU funziona, ma non tramite ROCm: la gfx1103 non è nella lista supportata ufficialmente da AMD, e Ollama lo scarta in silenzio durante l’avvio. Il percorso corretto è il backend Vulkan, che usa il driver Mesa RADV già presente su qualsiasi sistema Linux aggiornato. Lo abbiamo testato direttamente sul NiPoGi AM21 con Ryzen 7 8745HS: con la configurazione corretta, ollama ps mostra 100% GPU e la Radeon 780M viene riconosciuta con i suoi 16.6 GiB di RAM unificata disponibile.
Prima verifica che Vulkan sia installato e che RADV sia attivo:
sudo apt install vulkan-tools mesa-vulkan-drivers   # su Ubuntu/Debian
vulkaninfo --summary | grep -iE 'deviceName|driverName'
Su CachyOS e Arch il driver RADV è già incluso nel pacchetto mesa, non serve installare niente di extra.
Se vedi la tua Radeon nell’output (non llvmpipe, che è il fallback CPU), sei pronto. Crea il file di configurazione del servizio Ollama:
sudo mkdir -p /etc/systemd/system/ollama.service.dSu bash, poi incolla tutto in una volta:
sudo tee /etc/systemd/system/ollama.service.d/vulkan.conf << 'EOF'
[Service]
Environment=OLLAMA_VULKAN=1
Environment=GGML_VK_VISIBLE_DEVICES=0
Environment=LD_LIBRARY_PATH=/usr/local/lib/ollama/vulkan:/usr/local/lib/ollama
Environment=OLLAMA_FLASH_ATTENTION=1
Environment=OLLAMA_IGPU_ENABLE=1
EOF
Su fish shell l’heredoc non funziona. Usa nano invece:
sudo nano /etc/systemd/system/ollama.service.d/vulkan.confIncolla questo contenuto, salva con Ctrl+O e chiudi con Ctrl+X:
[Service]
Environment=OLLAMA_VULKAN=1
Environment=GGML_VK_VISIBLE_DEVICES=0
Environment=LD_LIBRARY_PATH=/usr/local/lib/ollama/vulkan:/usr/local/lib/ollama
Environment=OLLAMA_FLASH_ATTENTION=1
Environment=OLLAMA_IGPU_ENABLE=1
Poi ricarica e riavvia:
sudo systemctl daemon-reload && sudo systemctl restart ollamaTre cose da sapere prima di procedere:
OLLAMA_VULKAN=1 non OLLAMA_VULKAN=true: Ollama non riconosce la forma testuale, il backend Vulkan non parte. Nel log vedrai comunque scritto OLLAMA_VULKAN:true, ma è Ollama che lo converte internamente. Non è un errore.
OLLAMA_IGPU_ENABLE=1 è obbligatorio: senza questa riga Ollama vede la Radeon 780M via Vulkan ma la scarta comunque perché è una iGPU. È la variabile che sblocca tutto.
Non impostare HSA_OVERRIDE_GFX_VERSION: riattiva il percorso ROCm che crasha sulla gfx1103.
Dopo il riavvio, verifica che tutto funzioni avviando un modello e controllando in un secondo terminale:
ollama run llama3.1ollama ps
Se la colonna PROCESSOR mostra 100% GPU, la Radeon 780M sta lavorando. Se vedi ancora 100% CPU, controlla con cat che il file sia stato salvato correttamente e che OLLAMA_IGPU_ENABLE=1 sia presente.
Con questo setup, su un mini PC con Radeon 780M e 16GB di RAM unificata, puoi aspettarti 30-50 token al secondo su un modello da 8B invece dei 10-15 da sola CPU. Non è la velocità di una GPU dedicata, ma per uso quotidiano è fluido.
Su CachyOS e Arch Linux il pacchetto ollama-rocm può causare conflitti. Se hai problemi, rimuovilo e lascia solo il pacchetto base ollama.

GMKtec Mini PC EVO-X2 64+2T
AMD Ryzen™ AI Max+ 395 · 64 GB LPDDR5 · 2 TB
Wi-Fi 7, Bt5.4 · 3× USB-A 3.2 Gen2, 2× USB4, 2x USB 2.0, 1× lettore SD, 1x DP1.4, 1 HDMI 2.1, 2× jack audio 3,5mm

NiPoGi P1
ΑΜD PRO 7330U · 16 GB DDR4 · 256 GB
Wi-Fi 5 - Bt 4.2 · 1x HDMI2.0, 1x USB3.2 Type-C, 1x DP1.4, 1x LAN RJ45, 6x USB3.2 Gen1, 1x jack audio e 1x porta DC
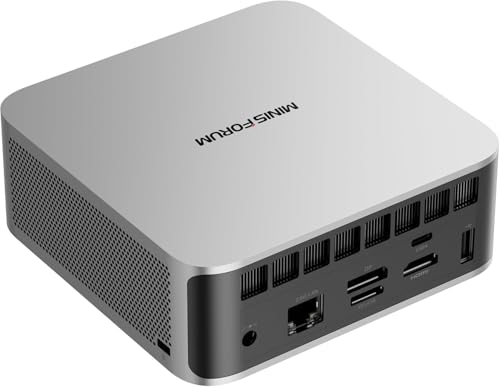
MINISFORUM X1 Lite-255
AMD Ryzen 7 · 16 GB DDR5 · 512 GB
Wi-Fi 7, Bt 5.4 · 2x USB-A 3.2, 2 x USB4, 1x Lan2.5, 1x HDMI2.1, 1x DP2.0, 1x Oculink

NiPoGi E3B
AMD 7430U · 16 GB LPDDR4 · 512 GB SSD
6x USB 3.2, 1x USB-C, 1x Lan, 1x DP1.4, 1x HDMI2.0, 1 Jack 3,5
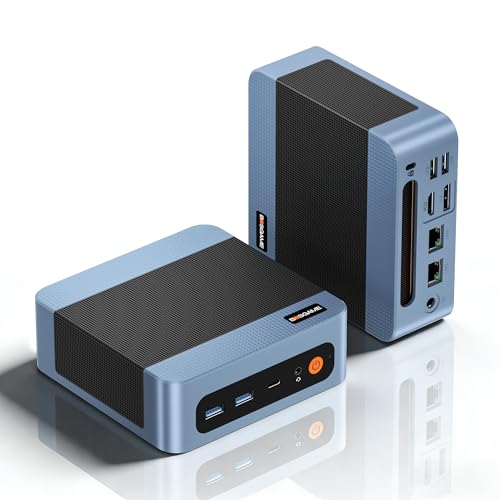
BOSGAME E5
AMD Ryzen 5 5300U · 16GB DDR4 · 512 GB
WiFi 5, BT5.0 · 2x USB-A 3.2, 2x USB-A 2.0, 1x USB-C 4K, 1x HDMI, 1 DP, 1x Jack audio, 2x Lan 1x DC-IN

Beelink SER9
AMD Ryzen AI 7 H350 · 32GB LPDDR5X · 1TB SSD PCIe4.0
Wi‑Fi 6, BT5.2 · 2x USB-A 3.2, 2x USB-A 2.0, 2x USB-C, 1x HDMI, 1 DP, 1x Jack audio, 1x Lan 2,5G, 1x DC-IN

Origimagic C4 Air
Ryzen 5 3500U · 8 Gb DDR4 · 256 GB
WiFi 5, BT5.0 · 3x USB-A 3.2, 1x USB-A 2.0, 1x USB-C 1080, 1x HDMI, 1 DP, 1x Jack audio, 2x Lan, 1x DC-IN

MINISFORUM AI X1 Pro
HX370 · 32 GB DDR5 · 1 TB
Wi-Fi 7 BT 5.4 · 2× USB-A 3.2 Gen2, 2× USB4, 1x USB 2.0, 1x DP2.0, 1 HDMI 2.1, 1× jack audio 3,5mm, Oculink

GMKtec M5 Ultra
AMD Ryzen 7 7730U · 16GB DDR4 · 1TB SSD
WiFi 6e, BT5.2 · 2x USB-A 3.2, 2x USB-A 2.0, 1x USB-C, 1x HDMI, 1 DP, 1x Jack audio, 2x Lan 2.5G, 1x DC-IN

NiPoGi AM21
Ryzen 7 8745HS · 16 GB DDR5 · 512 GB
Wi-Fi 6 bt 5.2 · 2x USB-A 3.2, 2x USB-A 2.0, 1x USB4, 1x USB-C, 2x HDMI, 1x Jack audio 3.5mm, 1x DC-IN (alimentazione)
A cosa serve concretamente
Dall’esperienza quotidiana, i casi d’uso dove l’IA locale ha senso rispetto al cloud:
Coding e debug. Puoi incollare codice sorgente senza preoccuparti che finisca a fare training da qualche parte. qwen2.5-coder per completamento e refactoring, un modello generalista per spiegare cosa fa un blocco di codice.
Riassumere documenti. Puoi incollare PDF, contratti, documentazione tecnica lunga. Un modello da 12B con contesto da 128K gestisce documenti di decine di pagine senza problemi.
Scrittura assistita. Bozze, email, testi da rivedere. Non per sostituire la scrittura, ma per avere un punto di partenza da modificare.
Traduzioni rapide. Qwen3 in particolare è molto forte in multilingua, italiano incluso.
Elaborazione batch in script. Siccome Ollama ha un’API locale compatibile con OpenAI, puoi chiamarla da Python o bash per automatizzare compiti ripetitivi senza pagare per ogni richiesta.
FAQ
Ho bisogno di una connessione internet?
Solo per scaricare il modello la prima volta. Dopo gira tutto offline.
I modelli capiscono l’italiano?
Gemma3, Qwen3 e Mistral funzionano bene in italiano. Llama3.1 è discreto. Per uso professionale in italiano, Qwen3 è attualmente il più affidabile.
Quanto spazio occupano i modelli?
Un modello da 8B in formato quantizzato Q4 occupa circa 4-5GB. Uno da 12B circa 8GB. Tienilo a mente se hai storage limitato.
Posso usarlo con VS Code o altri editor?
Sì. Ollama espone un’API locale compatibile con OpenAI, quindi plugin come Continue.dev puntano direttamente al tuo modello locale. Zero abbonamenti, zero dati che escono.
Vale la pena rispetto a ChatGPT?
Dipende dall’uso. Per velocità pura su domande complesse, i modelli cloud sono ancora superiori. Per privacy, costo zero, uso offline e automazione locale, l’IA locale non ha rivali. La maggior parte di chi la prova finisce per usarle entrambe, ciascuna per quello che sa fare meglio.
Non perderti i prossimi consigli
Guide, recensioni e novità su Linux, Mini PC e open source, dritte sul tuo Telegram. Niente spam, solo quello che vale la pena leggere.
IncastroPC partecipa al Programma Affiliazione Amazon EU. Prezzi e disponibilità soggetti a variazione.